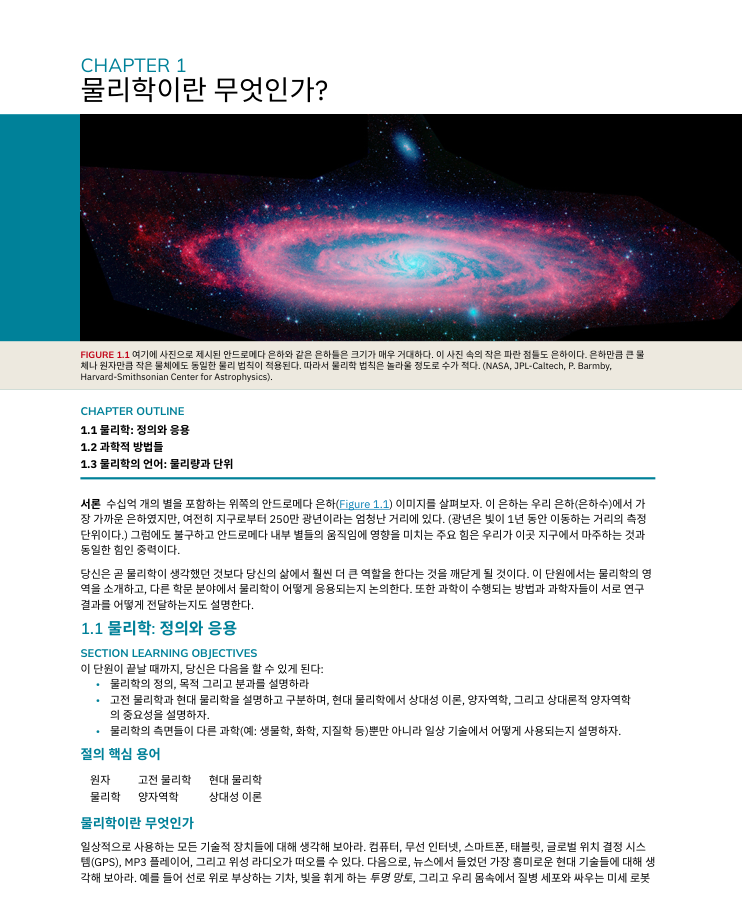
몇 주 전과 오늘 오픈스택스의 프리칼큘러스, 즉 대학 기초수학, 혹은 고등학교 수학 과정과 일반물리학 오픈스택스 책을 언어 모델을 활용하여 번역하면서, 시대의 변화에 대해서 느끼게 되었고, 나의 능력치라던지 이런 여러 제반 사항에 대해서 여러 가지로 객관적으로 파악을 할 수 있는 기회가 되었던 것 같다. 가장 먼저 시범적으로 시행한 것들은, 대학 기초수학 정도의 내용을 포함하는 프리칼큘러스(Precalculus)가 오픈스탁스 깃허브 저장소에 cnxml 파일 형태로 오래 전부터 공개되어 있었음에도, 나는 그것을 제대로 활용하지 못하고 있다가 구글의 챗봇 Gemini와의 대화 과정에서 알게 되었다.
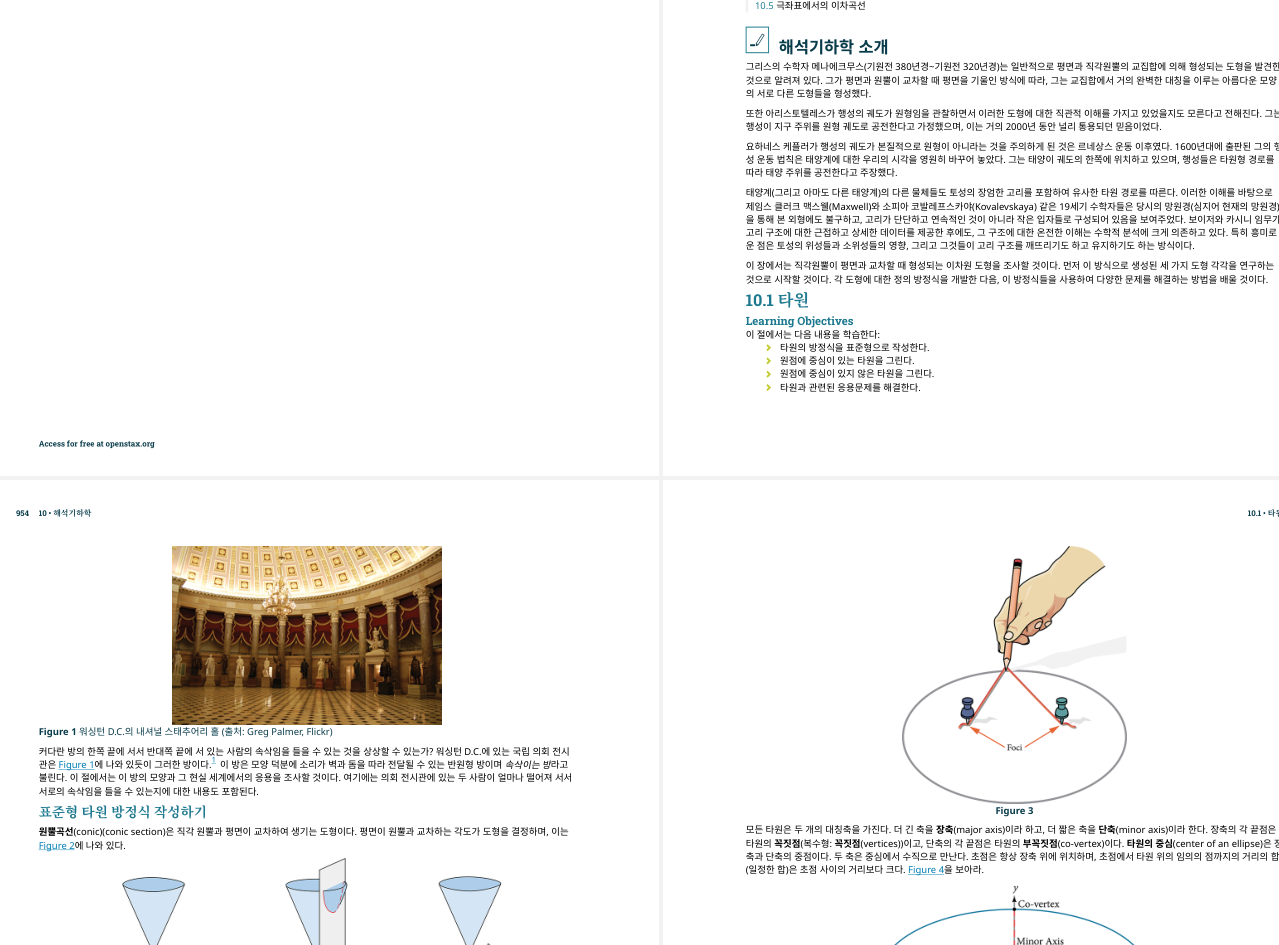
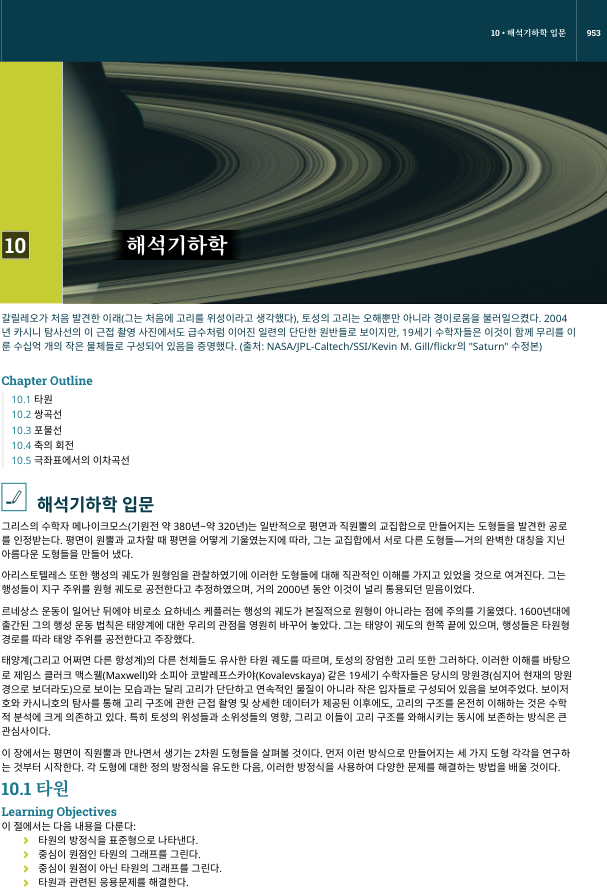
조판도구 enki를 OpenAI의 ChatGPT의 GPT 6이었는지 Google의 Gemini 4 이었는지 알 수 없지만, 암튼 같이 대화를 하면서 소개를 받았다. 다만, OpenStax 측에서 기본으로 올려놓은 조판도구는 그대로 사용하면, Precalculus 2판의 경우엔 Figure가 빠지는 문제가 있다. 다른 책들은 확인은 안 해봤는데 스타일이 그들이 제작한 것과 다른 문제점이 있다. 프리칼큘러스의 CSS 파일에서 너비 속성이 0인 이미지를 가진 Figure가 제대로 표시 안되는 문제가 있음을 파악할 수 있었고 정렬도 엉망이라는 것을 파악해서 대략적으로 비슷한 픽셀 단위의 정렬을 구현했지만, 조판도구 enki가 전역적으로 비슷한 스타일을 공유하고 또 업데이트가 삑사리나는 경우가 픽셀 완전하게 즉, 픽셀 단위로 그들의 공식 PDF 파일과 비슷하게 만들지는 못했다.
PDF 조판 성공한 이후 번역도 수학이 비교적 정형화된 문장들이니 규칙을 정해서 문장을 추출해서 번역하면 금방 이뤄질 것 같다고 생각을 했는데, 확실히 그대로 가능했다. 수식들이 있고 무수한 태그들이 있기 때문에 아마 그대로 넣으면 작업이 잘 진척되지는 않고 거의 카고 컬트 사이언스 수준 밖에 안되는 흑마술밖에 안 될 것이다. 언어모델이 아직까지는 출력의 품질이 일정하지 않고 튀기 때문에 이러한 비정형성을 별도로 체크하는 것이 필요하다. 프롬프트에 지시사항이 다단계로 들어가는데, 그것들을 모델이 전부 다 기억하지 못하고, 다 기억하는 고급형 모델을 쓰는 경우에는 비용이 대단히 비싸지는 문제점이 있다.
구글 Gemini 3.5 Flash Lite로 프리칼큘러스 초벌 번역 테스트에 성공했고, 5천원이 들었으며, 이후 Gemini 3.8 Flash에 11000원 가량 들여서 프리칼큘러스를 번역에 성공했는데, 대단히 짧은 문장 단위의 번역으로 요청이 들어가서 대단히 비효율적으로 작업이 진행된 면이 있다.
그래서 로컬 모델로 진행을 하려고 했는데, 내가 로컬 모델을 활용하는 수준도 대단히 낮다는 것을 현재에 와서 인지하는 것이지만, LM Studio Bionic의 옵션에 없다고 없는게 아니고 lms server start로 진행이 가능한데, 그걸 잘 모르고 ollama로 로드하고 gpu 풀로드인 걸 보고 끄덕이긴 했지만, 그나마 작업이 대단히 오래 걸리기 때문에 중간에 캔슬하고 한 며칠 정도 있다가 주말을 맞이하여 금요일부터 오늘까지 제대로 파보면서 NVIDIA RTX A2000 12GB 카드를 ECC 모드로 하스웰 제온 E3 32GB DDR3 ECC 시스템에 장착하고 테스트를 해봤고, 그 과정에서 LM Studio Bionic API의 실전 활용 감각을 얻게 되었다. 처음에는 윈도우즈 11 26H2 깔린 시스템이었지만, 지금은 우분투 서버 26.04로 통째로 갈아치워서 전반적 워크로드나 메모리 효율성이 개선되었다. 32GB RAM 중에서 5GB 정도 먹던 게 600MB로 줄어들면 그만큼 MoE 모델 등에 여유가 생기기 때문이다.
수 차례 테스트하면서 cnxml 파싱 및 번역 도구의 효율성을 개선. 이라고는 해도 Gemini 4 Argon에게 거의 다 던져준 수준이긴 하지만, 암튼 번역 과정의 오류가 가장 낮은 게 Gemma 4 12B임을 알게 되었다. 처음에 대충 번역을 문장 심지어 단어 단위로 구글 API로 대충 던져줄 때에 비하면 스크립트의 구조 개선만으로 효율이 거의 5배 가까이 향상되었으며, 품질 역시 거의 차이가 없는 수준이며, 비용은 아예 로컬 언어모델화로 거의 제로 수준, 즉 전기세 수준으로, 몇십원 가량으로 줄었다.
애초에 내가 파이썬을 잘 아는 것도 아니고, 또 프롬프트를 내가 스스로 스크립트를 들여다볼 만한 능력이 안 되거나 들여다보지 않기 때문에 품질을 개선하는 데에는 한계가 있는 면이 있다. 특히나 수식이 포함된 복잡한 조판 도구의 번역에서 실체적 문제는 문자열 치환자 방식으로 각 수식 및 컨텐츠의 위치를 표시하는 경우 LLM이 비결정론적이라 해당 치환자를 빼먹기 일쑤라서 이러한 문맥들을 보존하면서 자연스럽게 이어지도록 만드는 새로운 아키텍처가 필요하다.
이러한 아키텍처는 현재로서는 탁상공론이지만, 특정 위치나 문자열, 구에 대한 cnxml 파일의 전체적 구조 및 패턴을 보고 생각해볼 수 있는 문제다. 앞 뒤 맥락을 단순하게 부가해서 넣어주는 방식으로는 아마 잘 안 될 거고 그나마 그렇게 지시한다 한들 해당 부분의 앞부분 혹은 뒷부분만 출시하라는 지시를 명확하게 이행한다는 보장이 없는 것이 문제다.
그래서 RTX A2000에서 GPU 가속으로 온전히 돌아가는 언어모델 중에서 가장 활성 파라미터수가 많은 Gemma 4 12B QAT 모델이 오류가 가장 적게 잘 번역이 되는 것 같다.
뭐 2주 전인가 수학 책 번역을 해놓고 이후 진척이 중단된 것은 직장에서의 일로 주의집중이 분산되었던 면이 있고, 또 그 책을 가지고 실제로 수식을 쓰고 연습하는 시간이라던지, 혹은 운동을 하면서도 그 책을 본다던지 집중할 만한 여건이 되지 않는 면이 있었고, 또 PDF 파일 뷰어를 구하는 것만 해도 일이었는데, Moon+ Reader Pro 를 유료로 구매하면서 일단락되었다. 또 스마트폰을 포맷하고 초기화하면서 최소 수정의 원리에 따라 갤럭시 S5+, S9+를 순정 상태로 복구하고 adb에서 최소 수정의 원리로 손보는 것을 역시 AI와 대화하면서 주변 기기들을 정리하고 새로운 용도를 찾는 데에 혈안이 되어 있던 면도 있기 때문이다. 그 과정에서 갤럭시 폴드8 같은 무의미한 투자를 버리고 현재 가진 스마트 글래스와 갤럭시 S9+의 조합으로 결정되었고.
또한 직장에서 작업의 퀄리티도 최대한 높이는 것이 여러 가지로 인지적인 측면에서 이점이 있을 것이기 때문에, 그리고 실제로 이러한 집에서의 개인적인 학습 과정으로 직장에서의 업무 퀄리티 역시 확실히 증가한 면이 있다. 도면의 템플릿을 정리하고, 축척을 맞추는 그런 기초적인 작업이 그렇게나 어려운 일이었는지는 알 수 없는 일이지만, 그것도 아마 주의분산이라는 치명적 측면이 있었던 것인지는 알 수 없지만, 어쨌든 전임자들과 레거시들의 흔적은 그렇게 상당 부분 지워졌다.
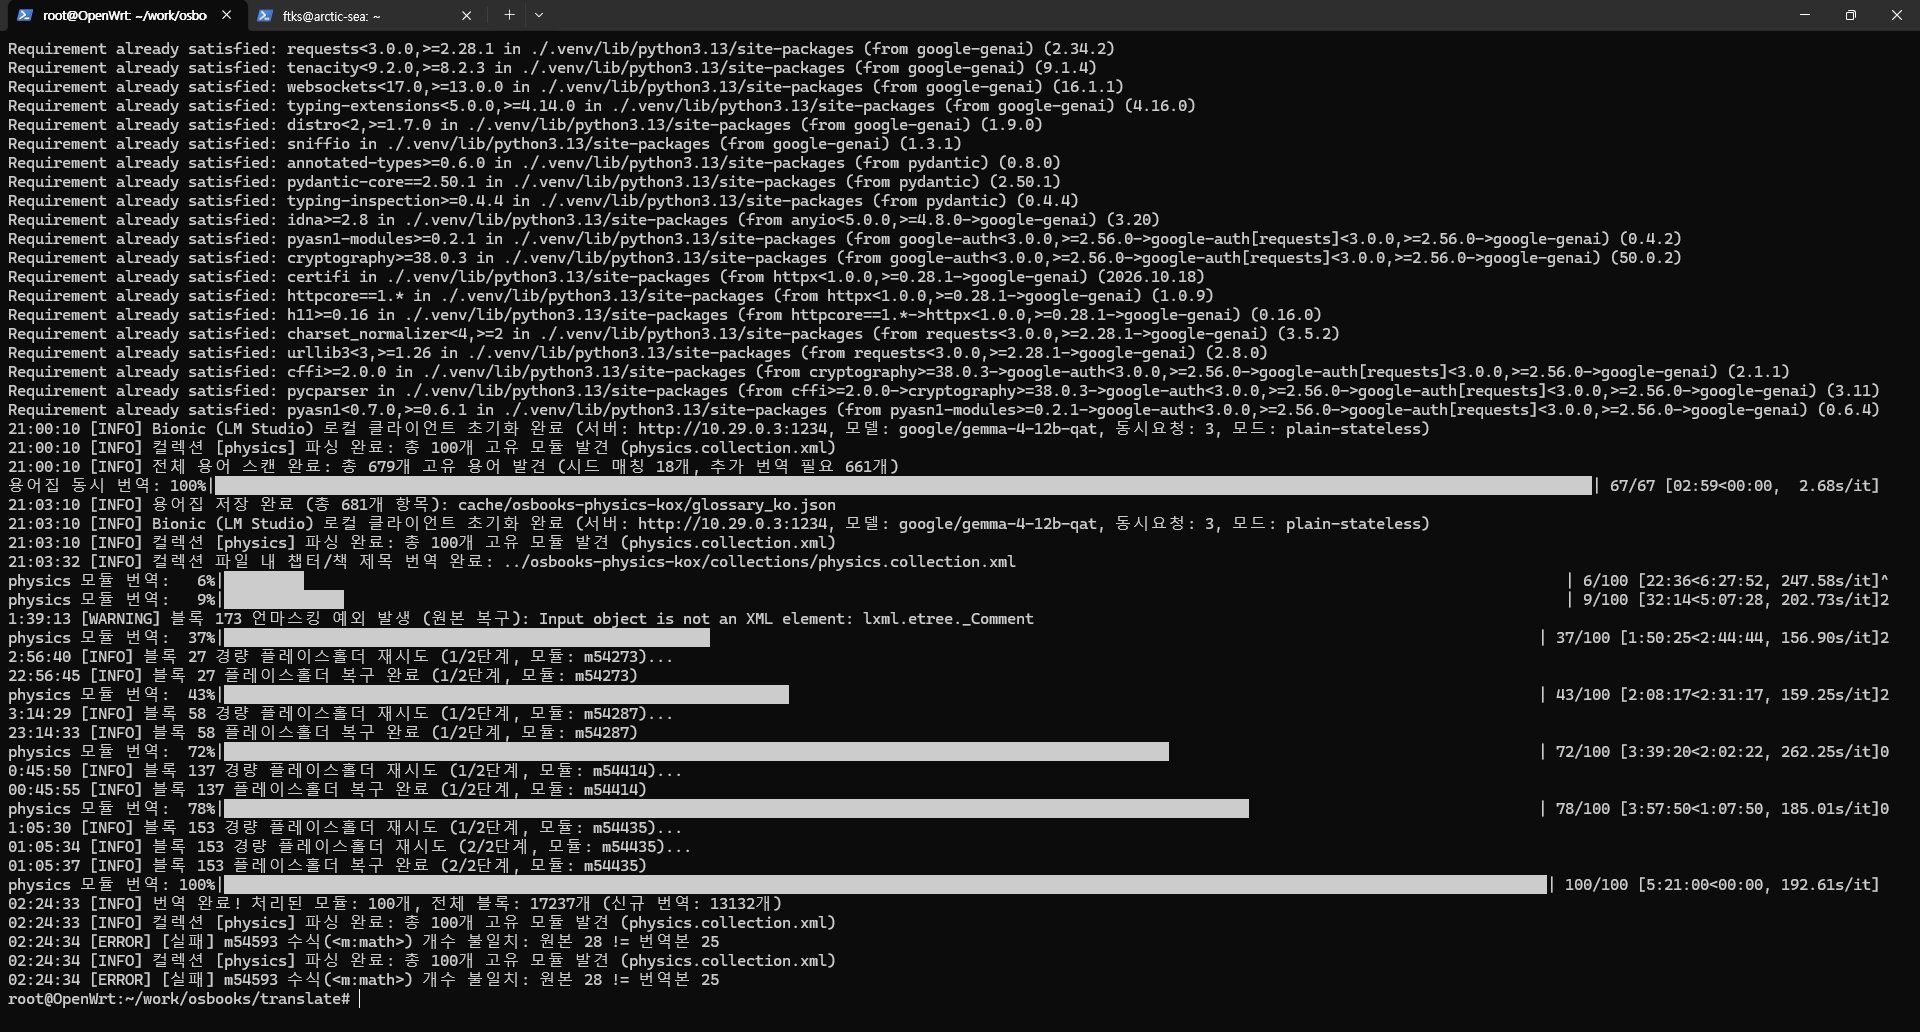
물리학 책은 일부 모듈, 전체 중의 1%긴 하지만, 특정 모듈에서 수식이 원본과 일치하지 않는 것이 있기 때문에 업로드는 하지 않을 것이다.